カウベルが鳴る曲は、何を歌っているのか ― 曲名の単語を数えてみた【MakeoverMonday 2026 W40】
公開日: 2026-10-18
カテゴリ: MakeoverMonday
今週のお題
今週のテーマは 「カウベルが使われている曲」のリスト です。出典は CowbellSongs.com で、データは「アーティスト」と「曲名」の2列だけ、661行というシンプルなものでした。
数値の列がひとつもないので、そのままでは棒グラフも散布図も作れません。そこで今回は 曲名を単語に分解して数える ことにしました。カウベルが鳴る曲のタイトルには、どんな言葉がよく使われているのか。それを、どのアーティストの、どの曲が支えているのか。この2つを1枚のダッシュボードで見られるようにしています。
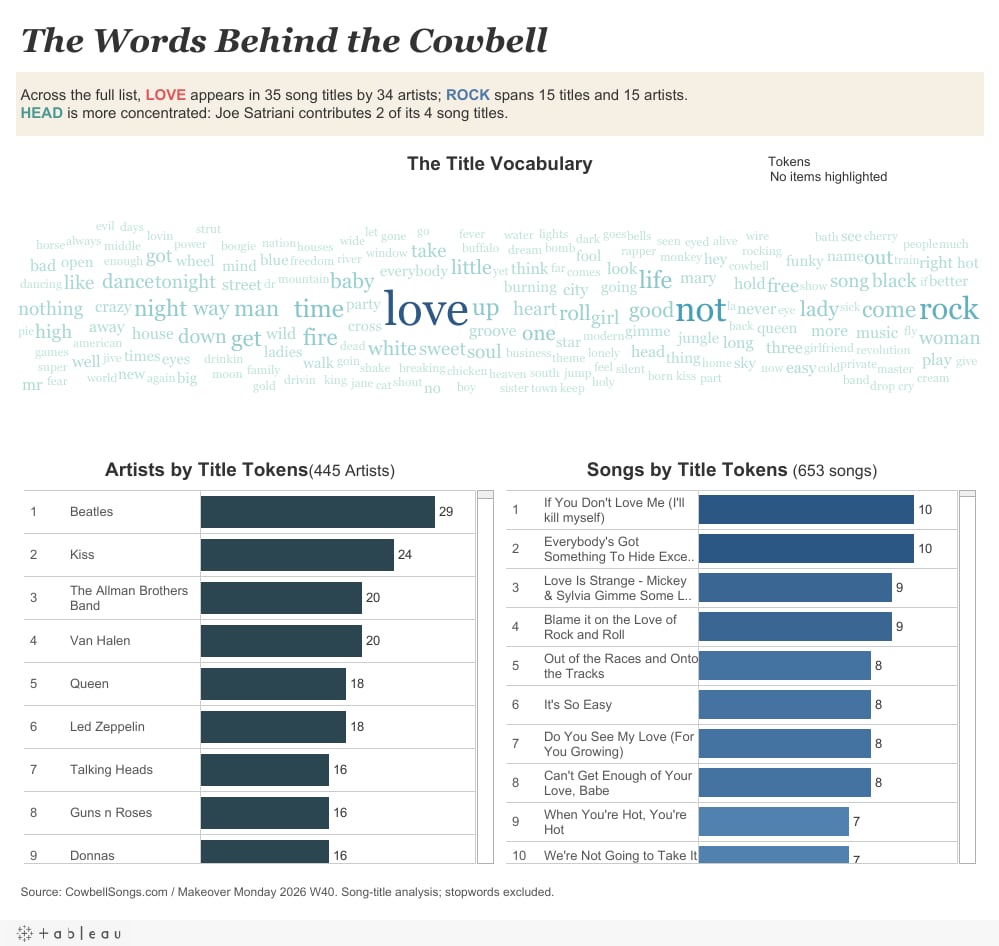
作成したダッシュボード
→ The Words Behind the Cowbell(Tableau Public)
工夫した点・こだわり
1. 「何曲に出るか」と「何組が使っているか」を分けて見る
単語の出現回数だけを数えると、1組のアーティストが同じ単語を何曲も使っているだけ、というケースを見分けられません。そこで前処理の段階で、単語ごとに 曲数(song_count) と アーティスト数(artist_count) を別々に集計しました。
その結果を、ダッシュボード冒頭の一文にまとめています。
- LOVE は35曲に登場し、アーティストは34組。ほぼ全曲が別のアーティストで、リスト全体に広く散らばっています
- ROCK は15曲・15組。すべて別のアーティストです
- HEAD は4曲だけですが、そのうち2曲がジョー・サトリアーニ(Joe Satriani)。少数のアーティストに偏っています
同じ「よく出る単語」でも、広く使われているのか、特定のアーティストの持ち味なのかで意味が変わります。その違いを、色付きの単語(LOVE/ROCK/HEAD)で冒頭に示しました。
2. 上段のワードクラウドで全体をつかみ、下段の棒グラフで順位を読む
上段は「The Title Vocabulary」と題したワードクラウドです。文字の大きさと色の濃さで、曲名によく出る単語が一目で分かります。
ただ、ワードクラウドは「なんとなく多い」は伝わっても、正確な比較には向きません。そこで下段に、
- Artists by Title Tokens(445 Artists):アーティスト別の、曲名に含まれる単語数
- Songs by Title Tokens(653 songs):曲別の、曲名に含まれる単語数
の2本の棒グラフを並べ、順位付きで読めるようにしました。アーティスト側の1位はビートルズ(29語)で、これはリストに載った8曲のタイトルの語数を足し上げた値です。曲側では「Everybody’s Got Something To Hide Except Me And My Monkey」と「If You Don’t Love Me (I’ll kill myself)」が10語で並んでいます。
3. どこをクリックしても、他の2枚が絞り込まれる
3枚のシートはすべて、クリックで他のシートを絞り込めます。
- ワードクラウドで love をクリック → 下段に、love を含む曲とそのアーティストだけが残る
- アーティストの棒をクリック → そのアーティストの曲名に使われた単語と曲だけが残る
- 曲の棒をクリック → その曲名を構成する単語だけが上段に残る
「単語 → 曲 → アーティスト」をどの方向からでもたどれるようにしたのが、今回いちばんこだわった点です。
使ったTableauの技術・Tips
前処理で「1曲×1単語」の縦持ちデータを作る
Tableau に読み込んだのは、元の2列ではなく、前処理で作った Tokens シートです。1行が「1曲×1単語」になった縦持ちの表で、主な列は次のとおりです。
| 列 | 内容 |
|---|---|
| normalized_tokens | 小文字化・表記統一した単語 |
| token_occurrences | その曲名の中での出現回数 |
| include_keyword | 分析対象なら1、機能語(the, of など)なら0 |
| exclusion_reason | 除外した理由(stopword など) |
前処理では、アーティスト名の表記ゆれ(「B’52s」→「B-52s」など)の統一、アーティストと曲名が入れ替わっていた行の修正、重複行の統合(5行)を行い、変更内容はすべて別シートに記録しました。また not / no / never は機能語でも除外せずに残しています。「Can’t」「Don’t」のような否定が曲名に多いことも、ひとつの特徴だと考えたためです。実際、not は19曲に出てくる2番目に多い単語でした。
除外した単語も行としては残しておき、ワードクラウド側でだけ include_keyword = 1 のフィルターをかけています。棒グラフの語数は除外語も含めた曲名全体の長さ、ワードクラウドは意味のある単語だけ、と使い分けるためです。
ワードクラウド:マークタイプ「テキスト」+サイズと色
ワードクラウドは、マークタイプを テキスト にして、normalized_tokens をテキストに、SUM(token_occurrences) をサイズと色に割り当てて作っています。行・列には何も置きません。
ただし、1回しか出てこない単語まで全部並べると、画面が小さな文字で埋まってしまいます。そこで次の計算フィールドで表示を絞りました。
// c.CNT of Token
COUNT([normalized_tokens])

// c.WordCloud表示
MIN([c.下段選択あり]) = 1 OR [c.CNT of Token] >= 2
初期状態では2回以上出てくる単語だけを表示し、下段で選択があるときは1回だけの単語も表示する、という考え方です。
INDEX() と SIZE() で順位と件数を見せる
棒グラフの左端の順位は、表計算 INDEX() を不連続に変えて行に置いたものです。タイトルの「445 Artists」「653 songs」は SIZE() をタイトルに挿入しています。どちらもビューに並んでいる行数から計算されるので、ワードクラウドで単語を選ぶと、順位も件数も絞り込み後の値に変わります。
ダッシュボードアクション(フィルター)で3枚をつなぐ
3枚のシートそれぞれを起点に、選択時に他のシートを絞り込むフィルターアクション を3本設定しています。いずれも「選択を解除したら全件表示に戻る」設定です。
設計の根拠:比較とランク付けには棒グラフ
Tableau の『ビジュアル分析のベストプラクティス』には、次の一節があります。
棒グラフは定量的な値を 1 つのベースライン上での長さとしてエンコードすることによって、とても簡単に値を比較することができるため、比較とランク付けに非常に適しています。
ワードクラウドは全体の雰囲気をつかむには便利ですが、文字の大きさは単語の長さにも左右されるので、正確な比較には向きません。そのため「全体をつかむ」役割はワードクラウドに、「順位を読む」役割は棒グラフに、と分担させました。
学び・振り返り
- 数値がないデータでも、数えれば分析できる。 2列のテキストだけでも、単語に分解して縦持ちにすれば、曲数・アーティスト数・出現回数といった数値が作れます。アンケートの自由記述や商品名の分析にも、そのまま使える進め方です
- 「どれだけ出るか」と「誰が使っているか」は別に数える。 回数だけを見ていると、HEAD のように特定のアーティストに偏った単語を見落とします。曲数とアーティスト数を分けて集計したことで、冒頭の一文が書けました
- 次回への課題。 下段の棒グラフは除外語を含めた語数なので、タイトルが長い曲ほど上位に来ます。「意味のある単語の数」で並べる版や、単語どうしの組み合わせ(rock と roll は7曲で一緒に出てきます)を見せる版も試してみたいと思います
⚠️ 注記: この記事はAIを活用して生成されています。内容に誤りが含まれる可能性があります。技術的な詳細については公式ドキュメントも合わせてご確認ください。